AI 视频需要一个故事
完成每个镜头,只解决了画面问题。这段十秒测试有月饼、朋友、满月与 Venus 标志,却缺少一个让观众继续看下去的理由。
线上的 AI 视频往往只展示最好的结果。我想记录一次真实尝试:如何从 Blender 分镜走到 AI 生成视频,以及为何结果仍未令我满意。
一个结局太容易猜到的团圆故事
三位朋友与 Venus 吉祥物在海边露营。吉祥物注意到月亮,朋友们抬头望向天空,满月最后变成 Venus 标志中的圆点。
概念有清楚的开场、结局与品牌转场。但完整的构思未必吸引:开场的月饼镜头,已经让人猜到故事的走向。
先在 Blender 测试故事 再逐镜生成
我在 Blender 以方块、球体与简单镜头建立十五秒分镜,检查角色位置、抬头时机与剪接次序。白模是一个低成本的故事测试,重点并非画面精致度。
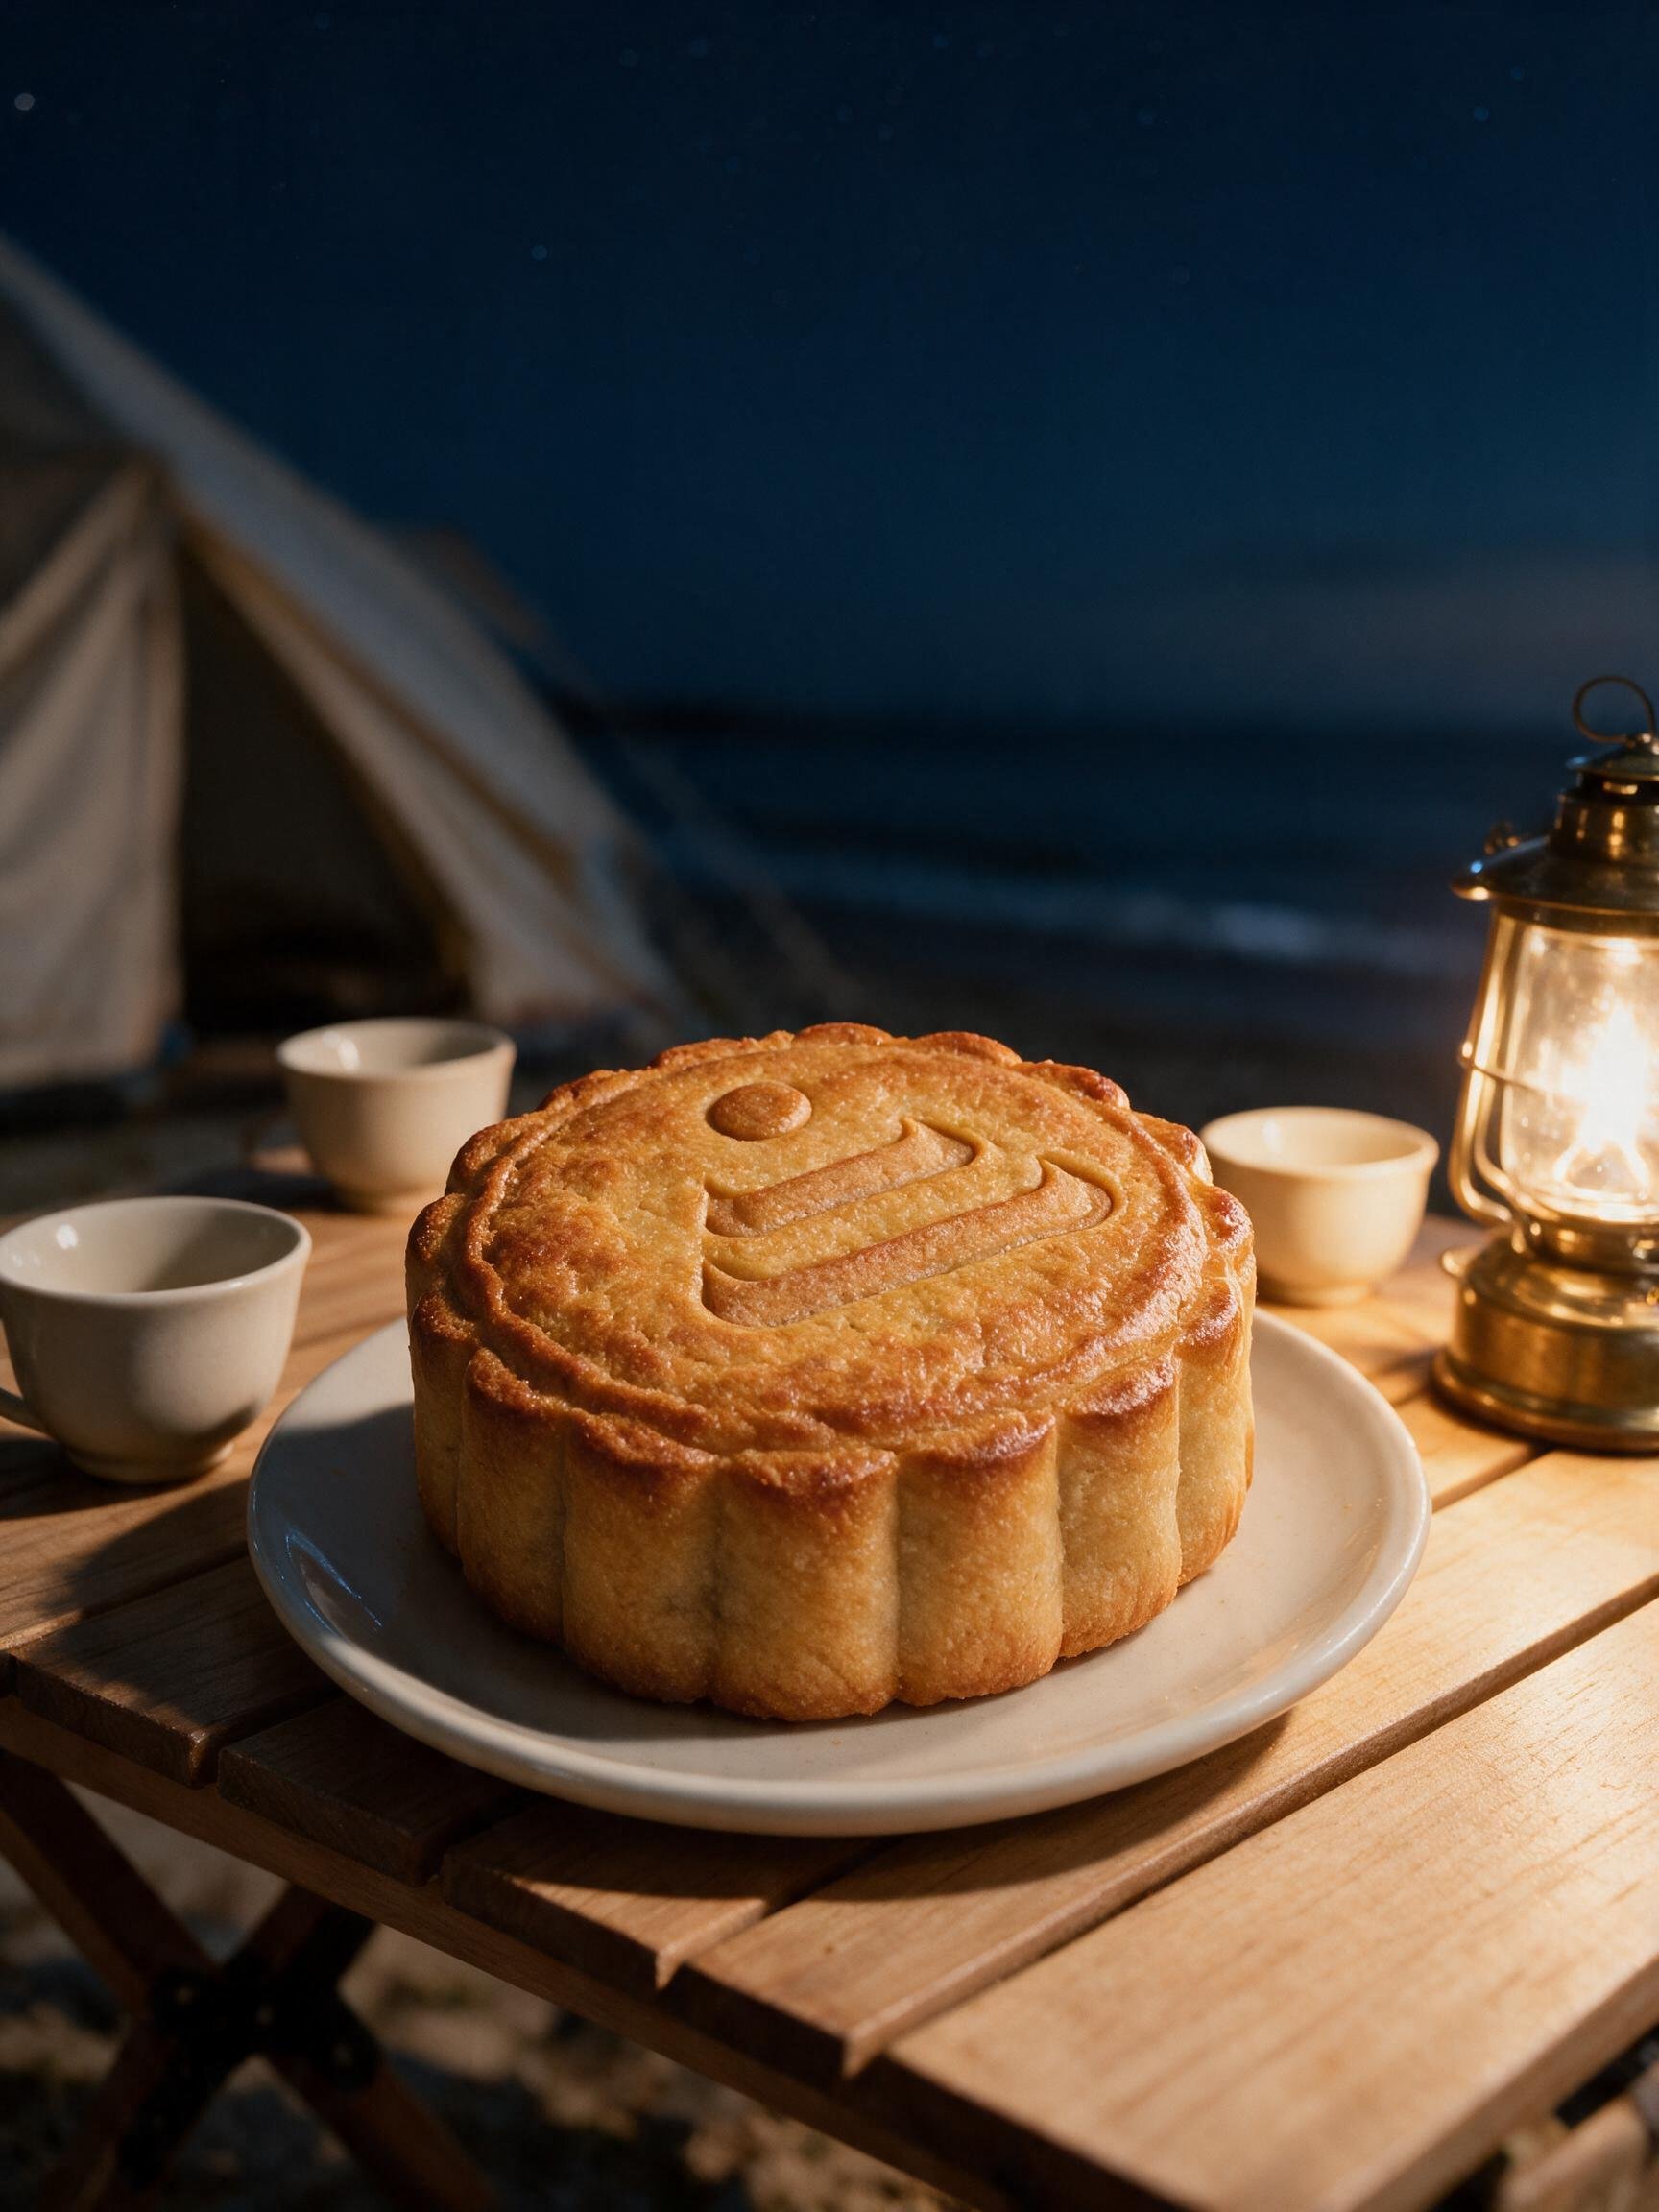
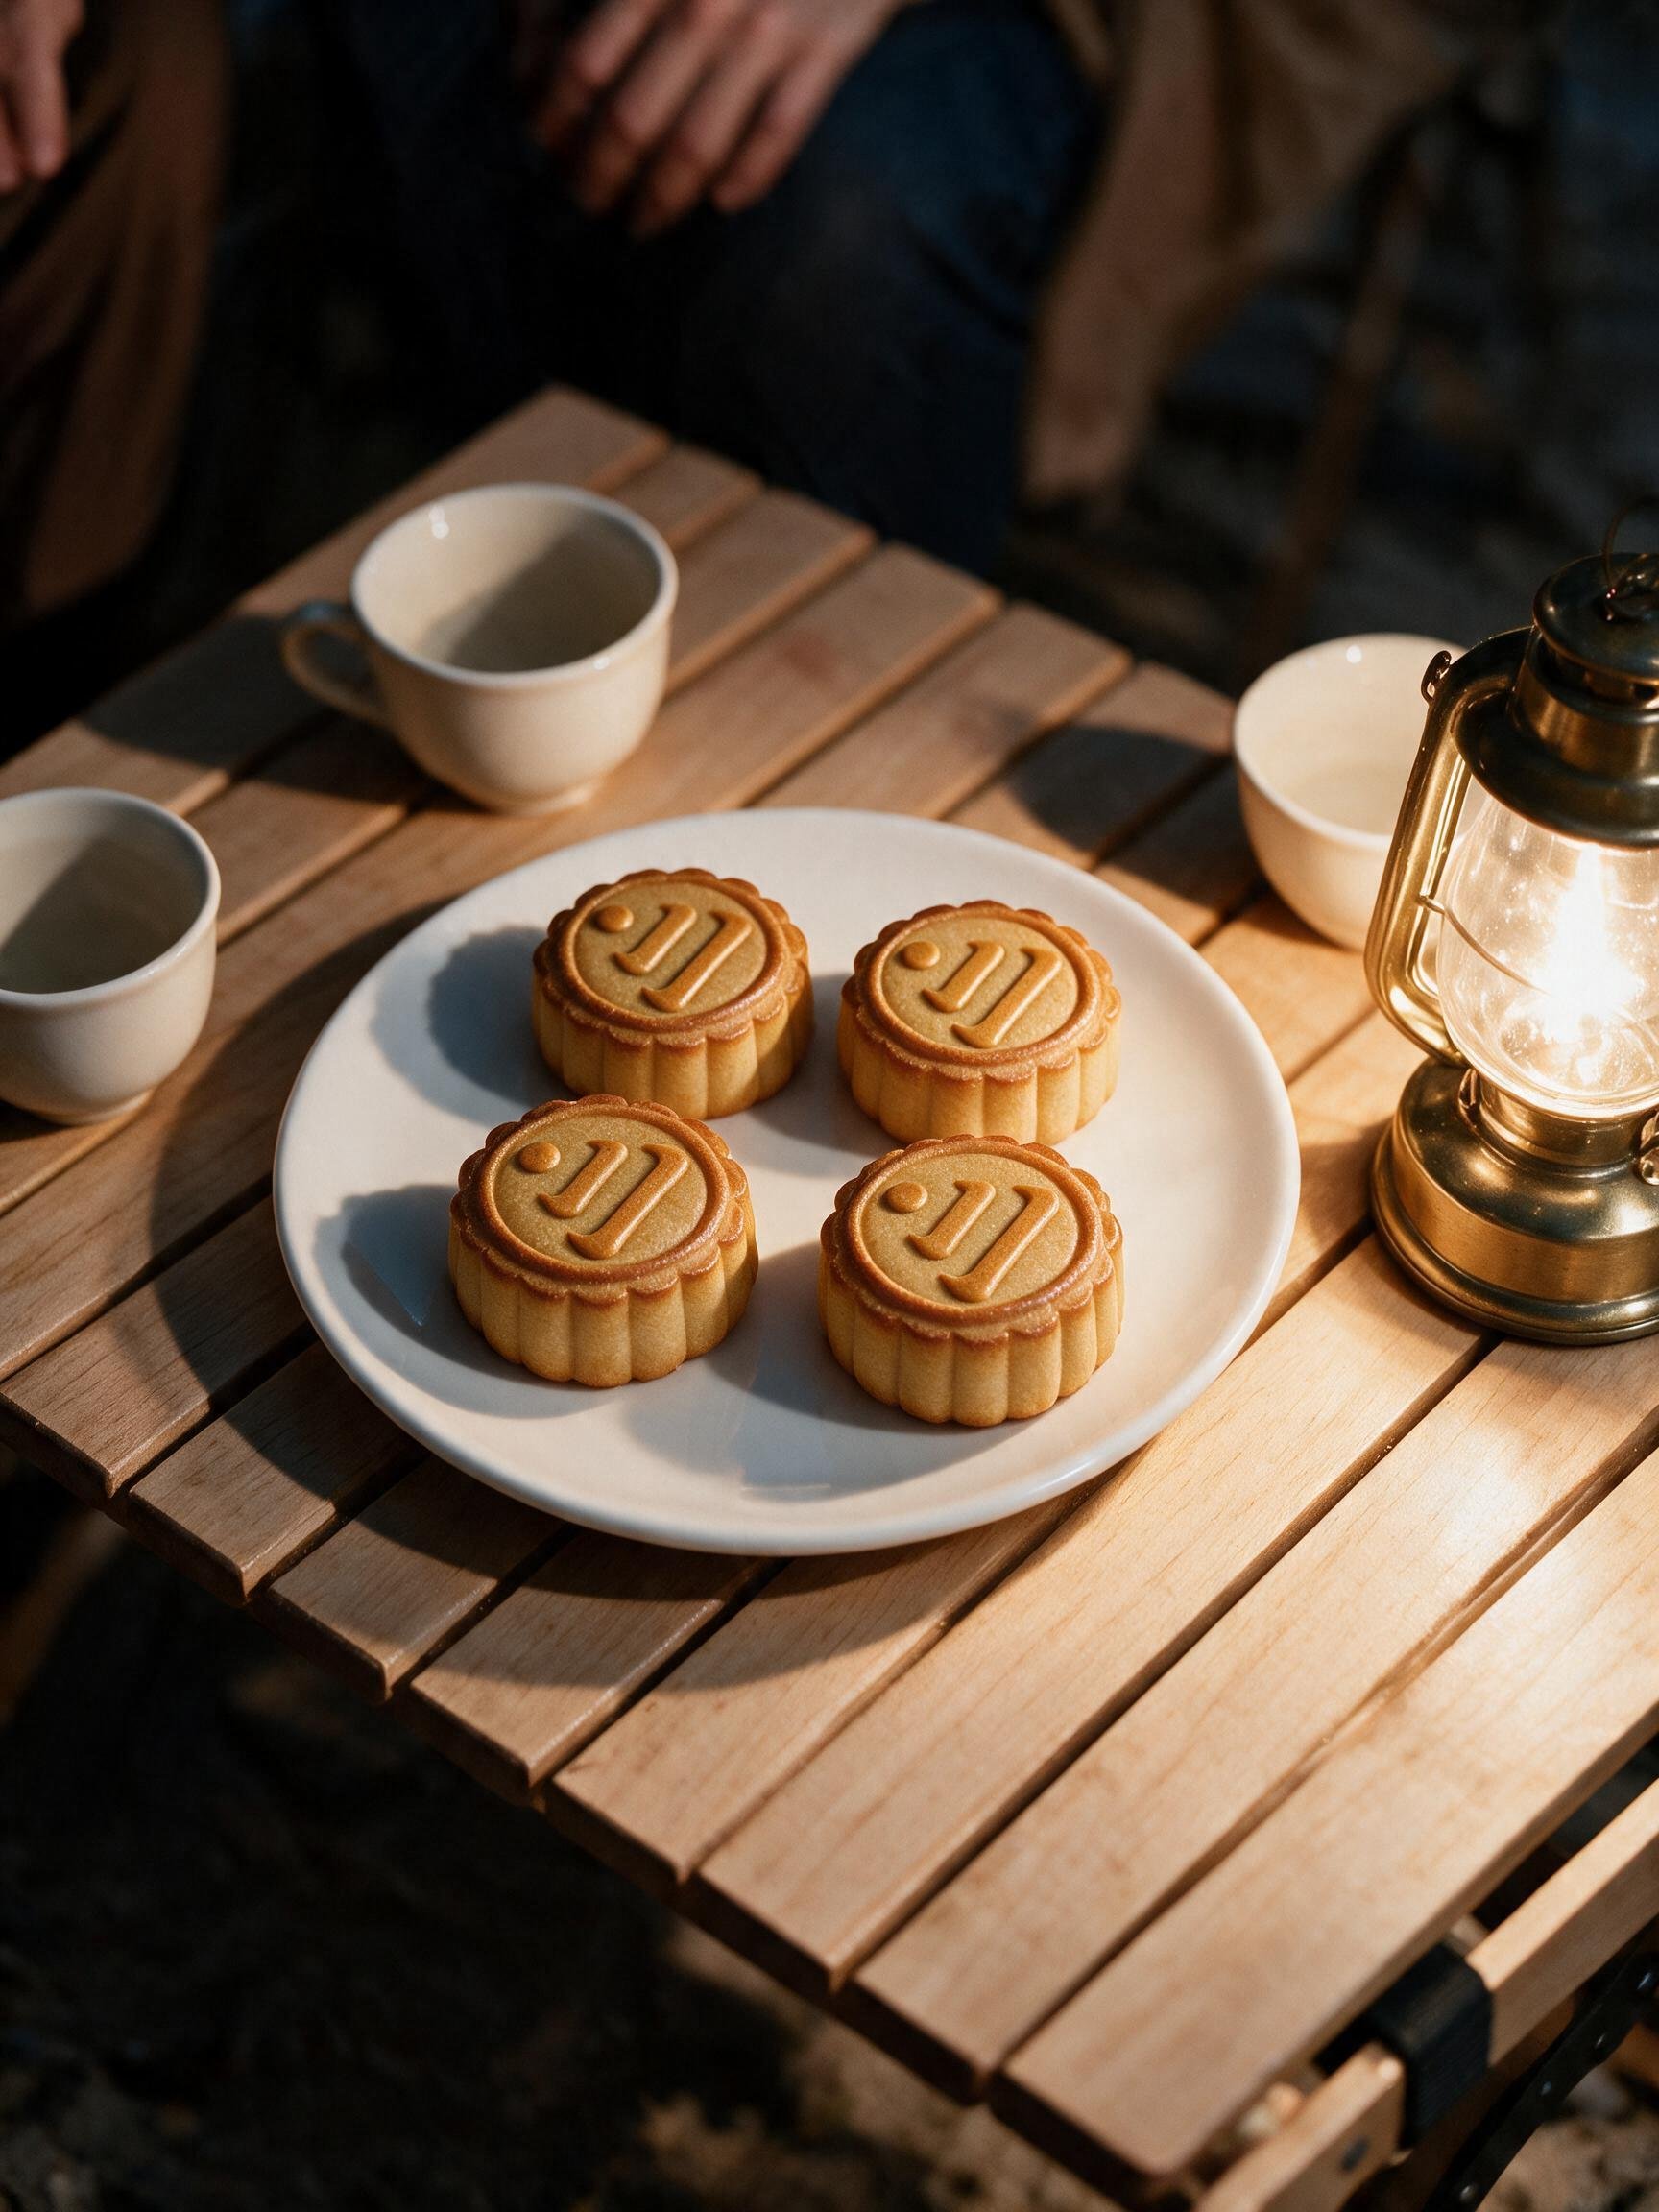
接着用 Dreamina 发展角色、营地、月饼与月亮,将故事逐段生成短片。视频参考负责说明动作,图片参考则确立外观与气氛。
更好的画面 未必带来更好的故事
我们修正过大的月饼、不准确的标志、消失的椅子,以及环绕月亮时不自然的镜头运动。每次修订都让画面更接近要求。
核心问题却仍然存在:角色大多只是坐着、微笑、抬头,吉祥物则指向天空。镜头有先后次序,但角色之间缺少有意义的事件、惊喜或回应。
如果粗剪本身乏味,再多生成,也可能只是把一段乏味视频修饰得更漂亮。
再次生成前,我会先测试甚么
- 01
先有一件事发生。 让一个角色做出行动,带动另一个角色回应。
- 02
每个镜头只负责一件事。 避免将场景、行动与反应全部塞进一次生成。
- 03
先看粗剪。 即使只有简单方块,也要问自己是否想继续看下一秒。
- 04
在后期完成品牌细节。 将准确标志、字体与精细转场留在可控制的流程中处理。
AI 品牌视频的实际问题
- 为甚么 AI 品牌视频会令人觉得乏味?
- 漂亮画面不能代替事件。观众需要知道角色想做甚么、发生了甚么,以及其他人如何回应。
- Blender 白模有甚么帮助?
- 在生成前测试镜头、位置、节奏与剪接,让故事问题更早浮现。
- 如何保持 AI 视频中的标志准确?
- 参考图可以引导结果,但不能锁定标志形态。需要准确的标志与字体时,应在后期合成原始素材。