AI 影片需要一個故事
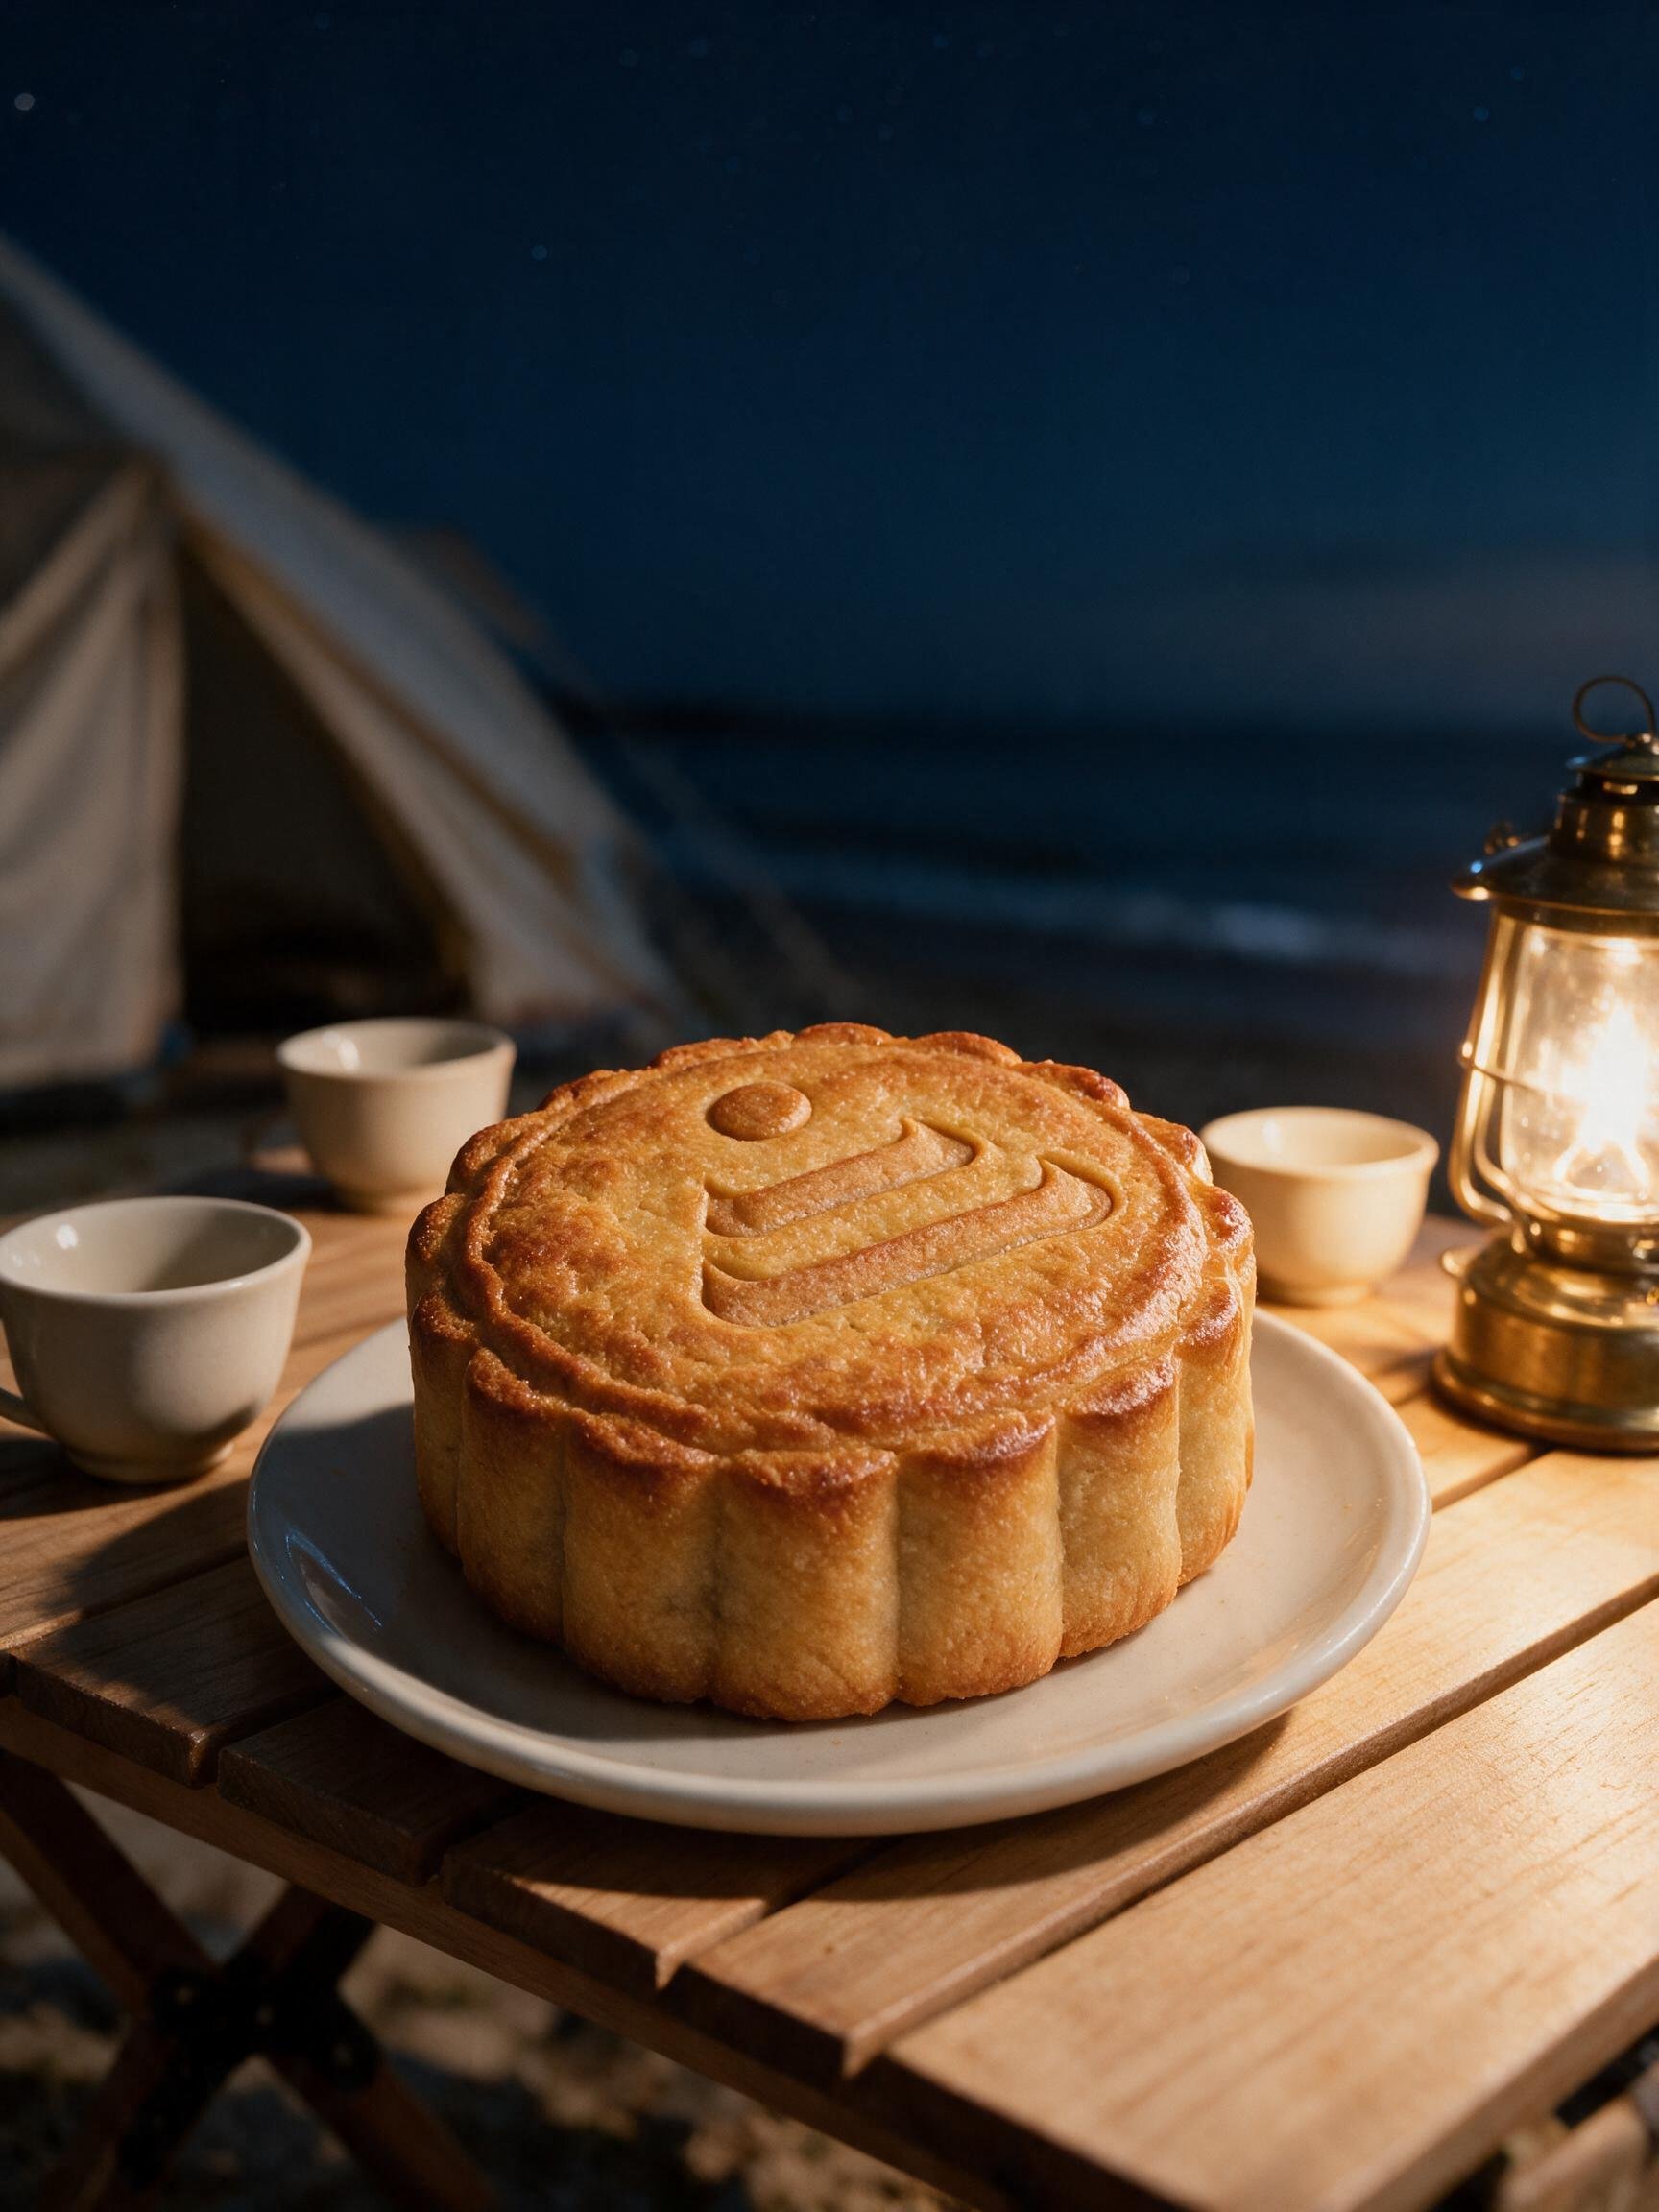
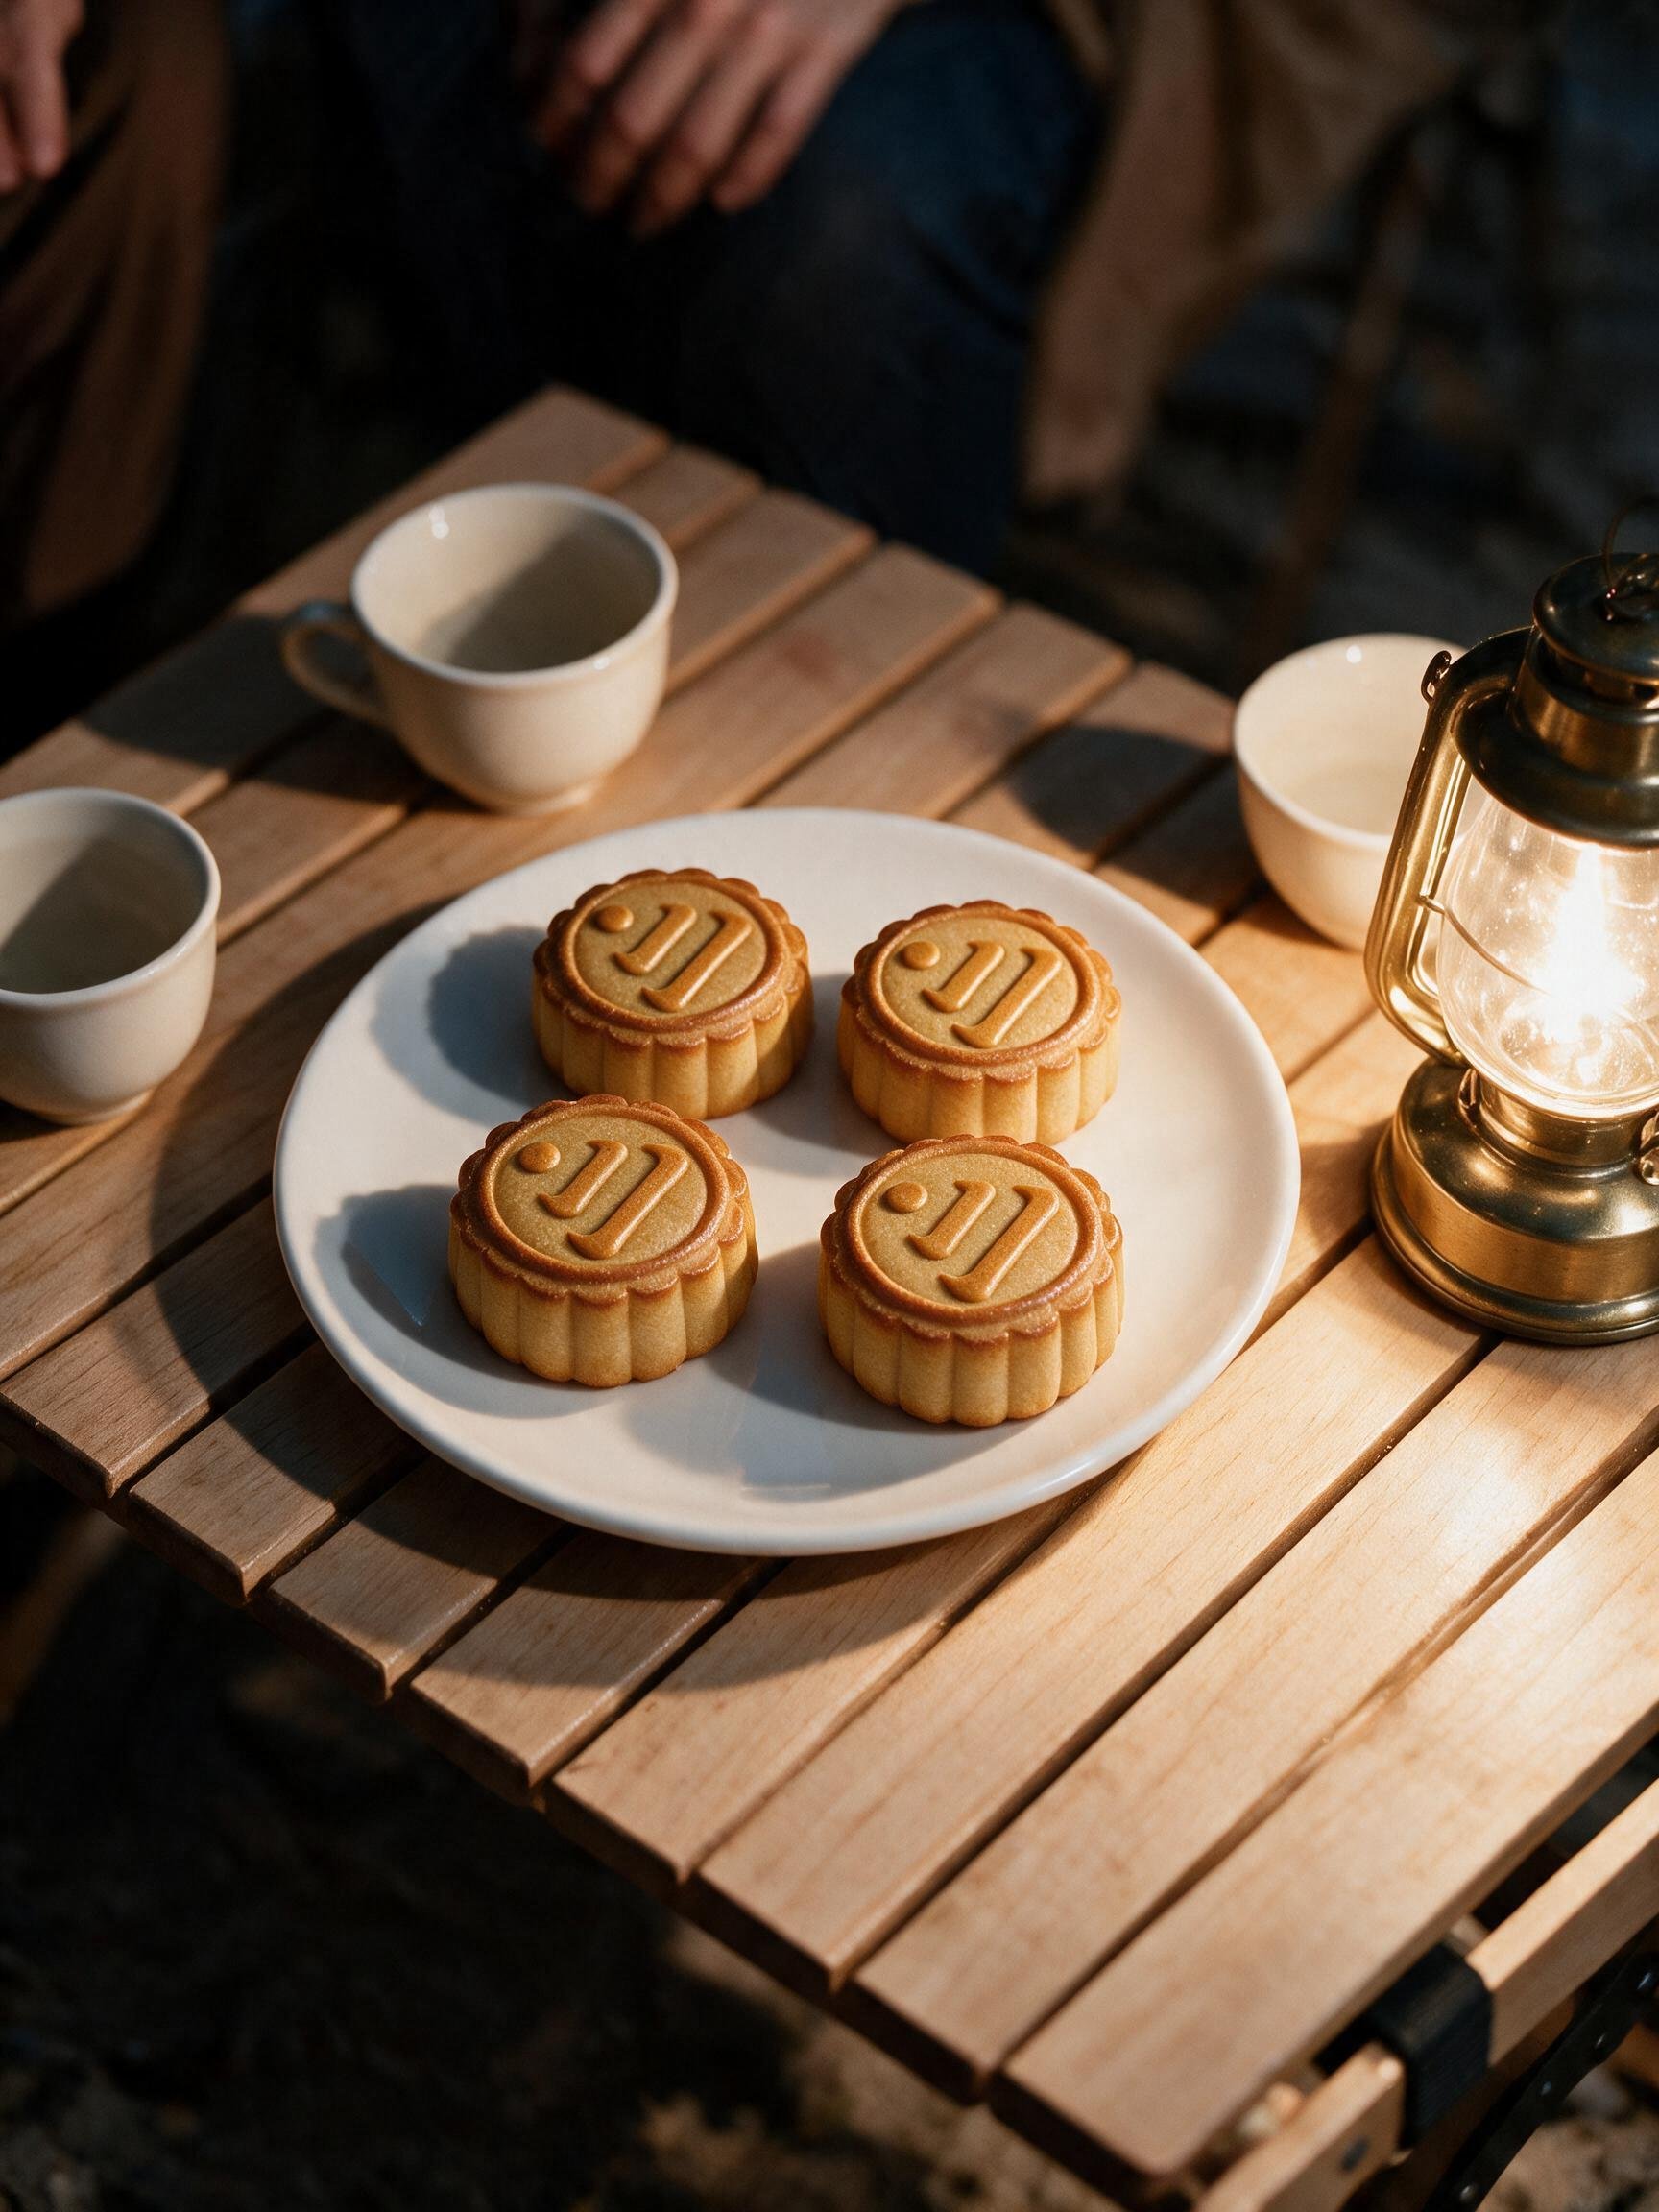
完成每個鏡頭,只解決了畫面問題。這段十秒測試有月餅、朋友、滿月與 Venus 標誌,卻缺少一個讓觀眾繼續看下去的理由。
網上的 AI 影片往往只展示最好的結果。我想記錄一次真實嘗試:如何從 Blender 分鏡走到 AI 生成影片,以及為何結果仍未令我滿意。
一個結局太容易猜到的團圓故事
三位朋友與 Venus 吉祥物在海邊露營。吉祥物注意到月亮,朋友們抬頭望向天空,滿月最後變成 Venus 標誌中的圓點。
概念有清楚的開場、結局與品牌轉場。但完整的構思未必吸引:開場的月餅鏡頭,已經讓人猜到故事的走向。
先在 Blender 測試故事 再逐鏡生成
我在 Blender 以方塊、球體與簡單鏡頭建立十五秒分鏡,檢查角色位置、抬頭時機與剪接次序。白模是一個低成本的故事測試,重點並非畫面精緻度。
接着用 Dreamina 發展角色、營地、月餅與月亮,將故事逐段生成短片。影片參考負責說明動作,圖片參考則確立外觀與氣氛。
更好的畫面 未必帶來更好的故事
我們修正過大的月餅、不準確的標誌、消失的椅子,以及環繞月亮時不自然的鏡頭運動。每次修訂都讓畫面更接近要求。
核心問題卻仍然存在:角色大多只是坐着、微笑、抬頭,吉祥物則指向天空。鏡頭有先後次序,但角色之間缺少有意義的事件、驚喜或回應。
如果粗剪本身乏味,再多生成,也可能只是把一段乏味影片修飾得更漂亮。
再次生成前,我會先測試甚麼
- 01
先有一件事發生。 讓一個角色做出行動,帶動另一個角色回應。
- 02
每個鏡頭只負責一件事。 避免將場景、行動與反應全部塞進一次生成。
- 03
先看粗剪。 即使只有簡單方塊,也要問自己是否想繼續看下一秒。
- 04
在後期完成品牌細節。 將準確標誌、字體與精細轉場留在可控制的流程中處理。
AI 品牌影片的實際問題
- 為甚麼 AI 品牌影片會令人覺得乏味?
- 漂亮畫面不能代替事件。觀眾需要知道角色想做甚麼、發生了甚麼,以及其他人如何回應。
- Blender 白模有甚麼幫助?
- 在生成前測試鏡頭、位置、節奏與剪接,讓故事問題更早浮現。
- 如何保持 AI 影片中的標誌準確?
- 參考圖可以引導結果,但不能鎖定標誌形態。需要準確的標誌與字體時,應在後期合成原始素材。